整个系统的分工很清楚:GPT-6 Astra 读取三路 RGB、任务指令和机器人本体状态,决定用哪只手、去哪里、末端朝什么方向、夹爪怎么开合以及这一段动作持续多久。固定控制库再把这些决定展开成连续轨迹,交给传统运动学和仿真系统执行。执行完一段,模型重新看场景,再决定下一步。
下面会沿着这条控制链一路拆下去,并用一次真实抓取和几组成功/失败案例对照着看。最后再回答一个很实际的问题:如果把同一套高层接口接到一台模型从没见过的机械臂上,哪些东西可以沿用,哪些必须重新适配。
材料全部来自这次实验留下的 codex-pilot20-v1 代码和记录:60 次 RoboDojo 评测、318 个决策点、35,646 个提交动作向量,以及对应的 RGB、机器人状态和 action。20 个任务 × 3 个 seed 全程使用 GPT-6 Astra xhigh。
为什么项目文件里还写着 Codex?
这轮 20 × 3 seed 测试实际使用的是 GPT-6 Astra,xhigh 模式。Codex / codex-pilot20-v1 是历史控制器和目录命名,所以仍会出现在代码、文件名和早期文档里。这里可以把两者简单区分开:GPT-6 Astra 负责看图和做高层决策;Codex-in-the-Loop 是把这些决策接到 RoboDojo 控制接口上的桥接与工具执行框架。单个 trial artifact 没有单独保存 model ID / generation configuration,完整 prompt history 和 token ledger 也没有归档。
1. 先看实验结果
这轮实验固定挑了 RoboDojo 的 20 个任务,每个任务跑 3 个 seed,共 60 次原生评测。
最终结果:
- 11 / 60 完整成功,成功率 18.3%;
- 平均原生得分 24.42 / 100;
- 20 个任务中,5 个至少成功过一次;
- 其中 2 个任务 3/3 全成功;
- 如果去掉此前有调试经验的
press_by_number,结果是 8 / 57 = 14.0%,平均得分 20.44。
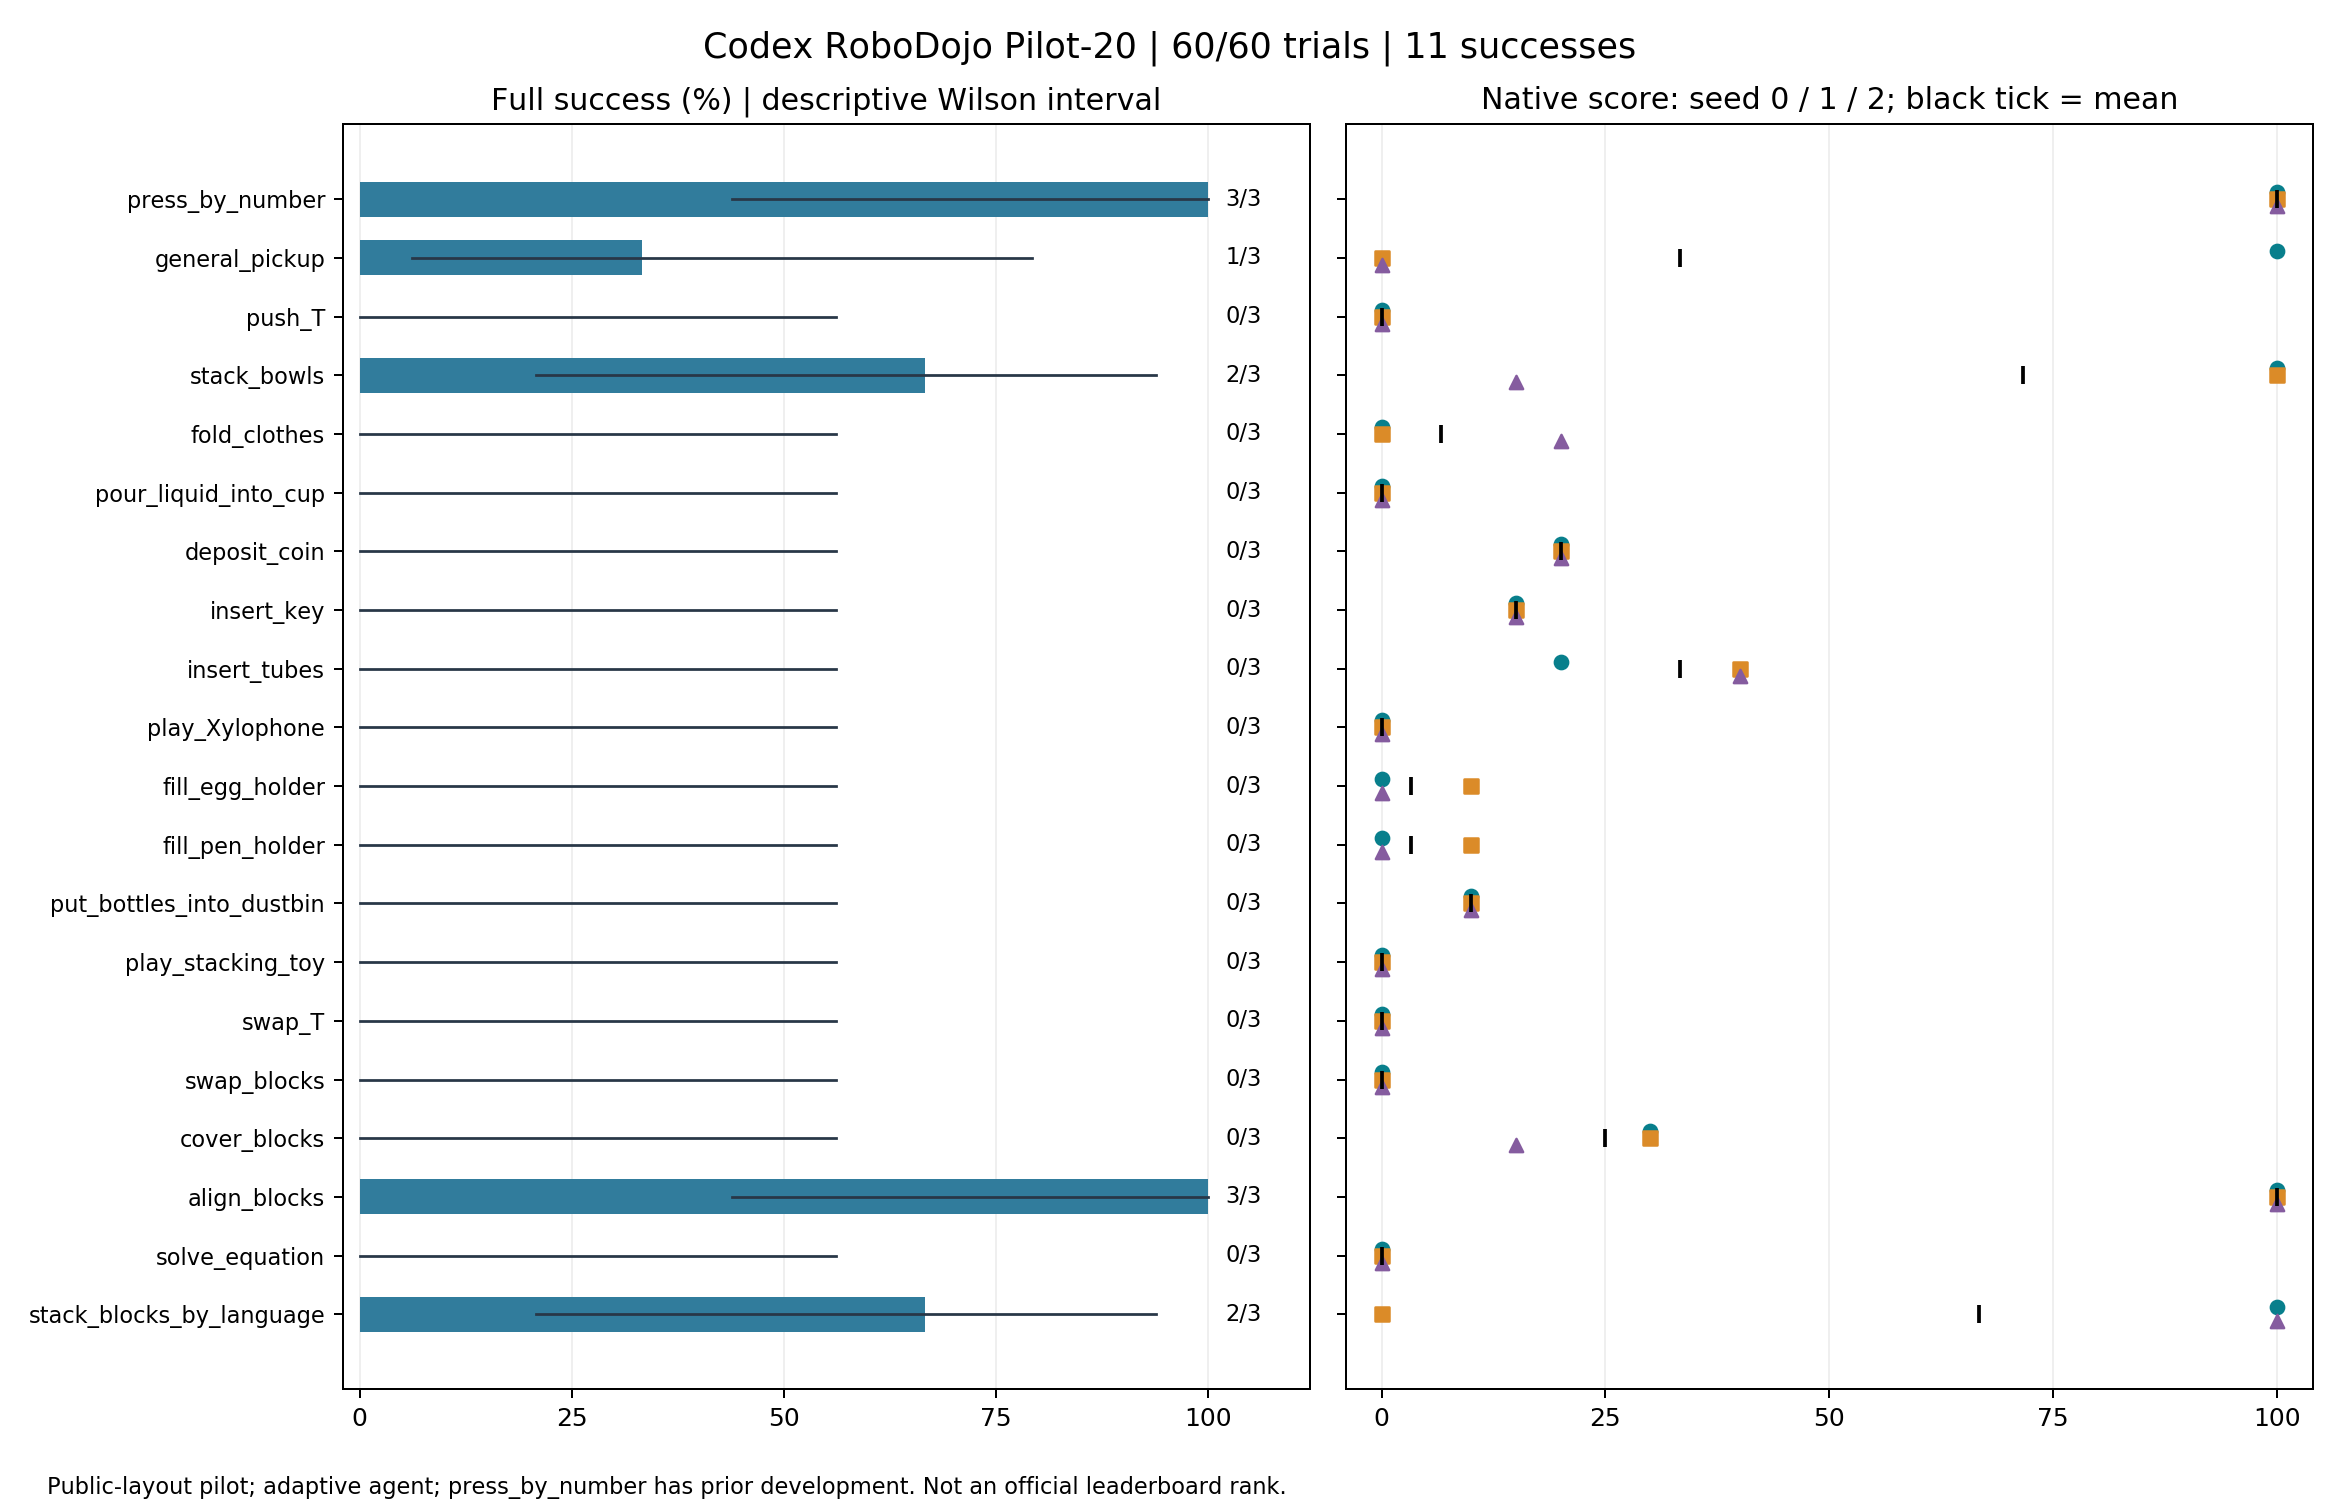
单看 18.3% 很难判断系统到底会什么。逐任务结果更有信息量:
| 类型 | 代表任务 | 结果 | 暴露出的能力/问题 |
|---|---|---|---|
| 空间重排 | align_blocks | 3/3 | 能看懂关系,失败后换接触策略 |
| 语言条件操作 | stack_blocks_by_language | 2/3 | 能记顺序并组合多个动作 |
| 一般抓取 | general_pickup | 1/3 | 能找到目标,但抓持稳定性不足 |
| 精密插入 | insert_tubes | 0/3,20/40/40 分 | 有部分进展,毫米级对齐困难 |
| 长序列 | put_bottles_into_dustbin | 0/3,均 10 分 | 单件可移动,累计误差大 |
| 符号推理 + 操作 | solve_equation | 0/3 | 题目可能看懂,但物理执行失败 |
这些结果把“理解任务”和“完成操作”之间的距离暴露得很清楚。模型可能已经找对目标、判断出正确放置位置,甚至算出了方程里缺失的符号;实际操作仍会因为抓取偏差、夹爪朝向、物体滑落或机械臂不可达而失败。RoboDojo 的最终 success 把这些环节统一压到一个结果里,这也是它难的地方。
2. 控制架构:低频决策,高频执行
这套实验把模型放在较低频的决策层。GPT-6 Astra 每隔一段动作看一次场景,生成少量高层命令;连续轨迹、逆运动学和物理执行由下层控制栈完成。整体结构如下:
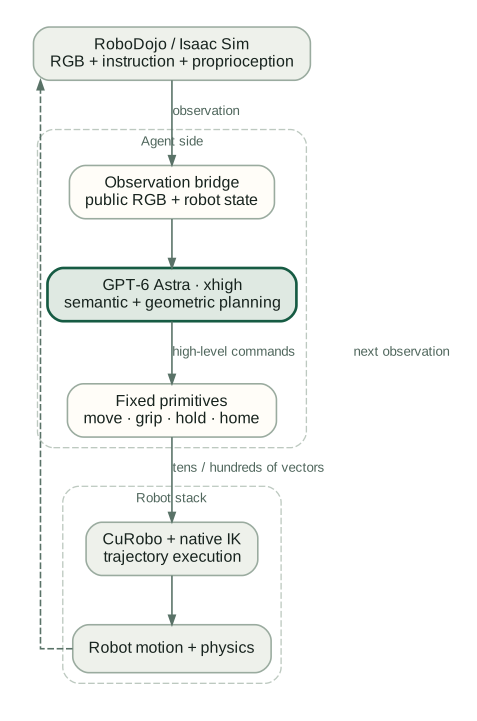
一次循环里,仿真器先导出当前 RGB、任务指令和机器人状态;GPT-6 Astra 根据这些信息选择下一段动作;control.py 把高层命令插值成平滑轨迹;CuRobo 和机器人接口处理运动学;Isaac Sim 执行并产生新的观测。模型负责语义理解、几何目标和恢复策略,下层控制栈负责连续数值执行。两者工作在不同时间尺度上。
3. 每次决策,Astra 实际看到什么?
实验对输入做了明确白名单。每一个 decision point,控制器只导出四类信息。
3.1 三路普通 RGB
- 头部相机
cam_head - 左腕相机
cam_left_wrist - 右腕相机
cam_right_wrist
下面就是一次真实的 general_pickup 初始头部 RGB。任务是:
Pick up the mint green scissors by 10 cm.
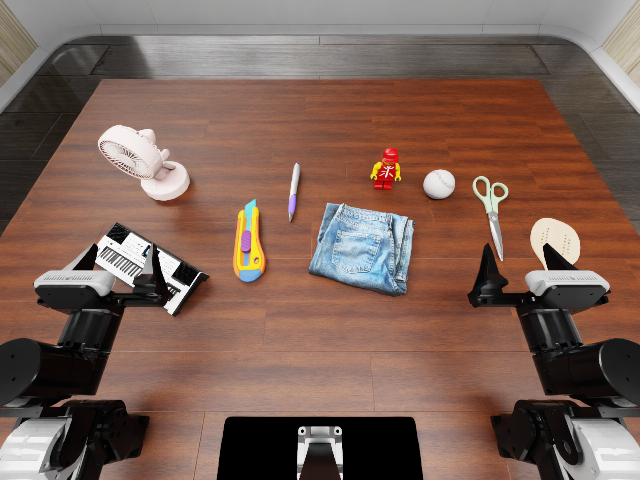
图像是普通的 640×480 RGB。模型没有直接得到“剪刀的三维坐标”。
3.2 自然语言任务指令
例如:
Pick up the mint green scissors by 10 cm.或者:
Stack the blocks according to the language instruction.模型必须把语言和视觉对应起来:什么是目标物、任务要求什么、结束条件大概是什么。
3.3 机器人 proprioception(本体状态)
左右臂各只导出三个字段:
left_arm_joint_state
left_ee_pose
left_ee_joint_state

right_arm_joint_state
right_ee_pose
right_ee_joint_state
其中:
arm_joint_state:机械臂当前关节状态;ee_pose:end-effector 当前位姿;ee_joint_state:夹爪状态。
末端位姿统一表示为:
[x, y, z, qw, qx, qy, qz]因此模型可以读到两只机械臂当前在哪里、夹爪处于什么状态;场景物体的 simulator ground-truth pose 并不会随 observation 一起导出。
3.4 公共静态机器人/相机参数
实验允许使用机器人自身的公共几何和静态相机标定,例如:
- 相机内参;
- 相机相对于机器人坐标系的位置;
- 机器人可用的坐标约定;
- 末端目标的格式和工作空间约束。
这些不属于场景特权信息。它们更像一台机器的说明书和出厂标定。
4. 输入边界:哪些信息可以用,哪些不能用
3D waypoint 容易引起误会。实验里它由模型根据视觉和标定估出来,属于动作输出;控制器没有把场景物体的真实三维坐标直接提供给模型。输入边界可以从下面这张表看得更直观:
| 信息 | 是否提供给 GPT-6 Astra | 是否属于环境特权信息 |
|---|---|---|
| RGB 相机画面 | 是 | 否 |
| 任务自然语言 | 是 | 否 |
| 自身关节状态 | 是 | 否 |
| 自身末端位姿 | 是 | 否 |
| 相机静态标定 | 可用 | 通常否 |
| 机器人几何/坐标约定 | 可用 | 否 |
| 物体真实 3D pose | 否 | 是 |
| depth / segmentation | 否 | 本实验中被排除 |
| scene layout 答案 | 否 | 是 |
| reward 内部状态 | 否 | 是 |
| expert trajectory | 否 | 是 |
| reference action | 否 | 是 |
这里的判断标准很简单:waypoint 的几何信息来自传感器观测和公开标定,还是来自 simulator 的场景真值。本实验采用前一种路径。控制桥有明确白名单,控制器代码也不导入 task/env;不过整个交互会话没有做独立的信息隔离审计,因此项目文档使用了更克制的说法:restricted public-observation bridge。
5. 从一张 RGB 到一个 3D 抓取点:它是怎么“猜坐标”的?
项目里的 pixel_to_plane.py 很短,却能直接看出这套几何定位方法的思路。
假设模型在 RGB 中认为目标中心大概位于像素:
(u, v) = (490, 215)模型再根据视觉估计目标高度,例如假定目标大致位于桌面上方某个 z 平面。
程序做的是:
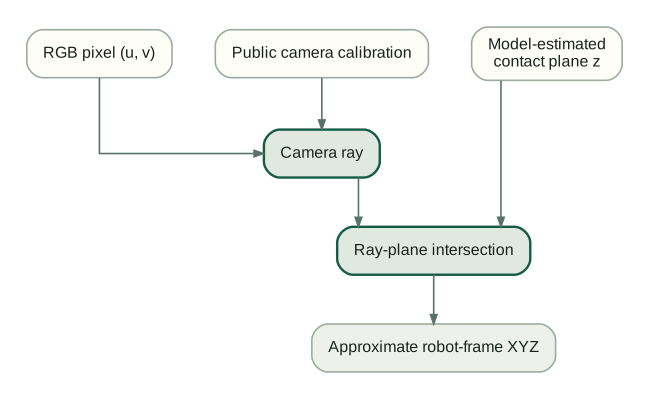
数学上本质是一个 ray-plane intersection:
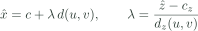
其中估计高度 ẑ 由控制器根据画面判断,没有深度传感器提供直接测量。误差主要来自下面几个地方:
- 物体不是平的;
- 抓取点高于桌面;
- 相机有透视;
- 目标被遮挡;
- 物体中心并不是正确接触点;
- 一个看起来“差不多”的三维点,可能在实际夹爪几何上根本不好抓。
这也解释了为什么本实验在精密插入和细长物体抓取上明显更困难。
6. 它能发出哪些动作?
模型真正能调用的高层动作只有 4 个:
move
grip
hold
home
这些 task-specific 函数并不存在:
insert_key()
stack_bowls()
solve_equation()
工具层没有 insert_key()、stack_bowls() 这类任务专用函数。对象选择、任务分解、waypoint、姿态以及失败后的恢复动作,都需要模型在交互过程中给出来。
6.1 move
一个真实的命令大致长这样:
{
  "kind": "move",
  "arm": "right",
  "pose": [0.3723, -0.0539, 1.04, 0.5, -0.5, 0.5, 0.5],
  "gripper": 1,
  "steps": 30,
  "hold": 3
}
这里模型实际决定了:
arm:哪只手;pose:去哪个三维位置 + 什么方向;gripper:夹爪状态;steps:这段轨迹有多长;hold:到达后保持多久。
6.2 grip
{
  "kind": "grip",
  "arm": "right",
  "value": 0.12,
  "hold": 10
}
不仅可以开/关,也允许类似 0.12、0.25 这样的部分闭合。
6.3 hold
保持当前目标若干 action vectors,让物理系统稳定、等待物体落下,或者在动作之间停顿。
6.4 home
home 会读取 episode 第一次 observation 中的初始关节状态,再把当前关节状态插值回去;目标姿态随该 episode 的初始状态而定。
7. 高层命令怎样变成连续轨迹
假设 GPT-6 Astra 只给出一条高层指令:
右手从当前位置移动到 P,30 steps。控制代码不会让机器人瞬移到 P,而会生成一串中间目标:
pose_1
pose_2
pose_3
...
pose_30
位置采用线性插值:
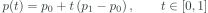
姿态使用 quaternion SLERP,避免四元数方向突然跳变。
例如,一条高层命令可以展开为:
GPT-6 Astra 的 1 条 move
        ↓
控制库
        ↓
30 个平滑的 Cartesian action vectors
如果一轮里 GPT-6 Astra 给出:
move above object
move down
grip
move up
hold
就很容易被展开为几十甚至上百个数值动作。
这一层承担的是轨迹生成:把稀疏的目标位姿变成连续、平滑、可交给机器人执行的参考轨迹。任务目标和 waypoint 仍来自上层模型。
8. CuRobo 在哪一层接手?
GPT-6 Astra 通常输出的是末端位姿:
[x, y, z, qw, qx, qy, qz]但真实机械臂需要的是关节运动。
因此可以把职责理解成:
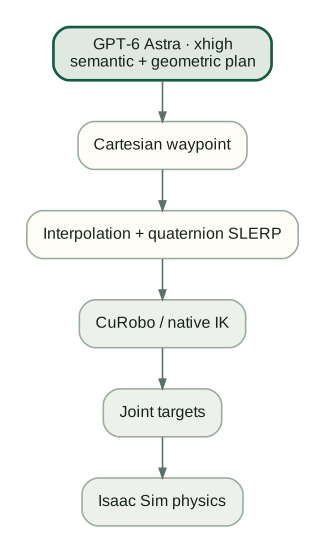
具体到下面这些关节角,计算发生在下一层:
joint_1 = 0.317 rad
joint_2 = -1.028 rad
...
逆运动学和运动规划由机器人栈处理。这样一来,GPT-6 Astra 可以把注意力放在目标、空间关系和动作策略上,不必直接计算每个关节的数值。
9. 跟着一次真实抓取走完整个闭环
这一段直接看归档里一次真实的 general_pickup:任务是把薄荷绿色剪刀抬高 10 cm。
第一步:看头部 RGB,识别目标
任务:
Pick up the mint green scissors by 10 cm.模型看到前面的头部图后,记录的可见简短决策理由是:
RGB 指令要求拿薄荷绿色剪刀。它位于画面右侧;根据像素位置、公共相机标定和桌面高度假设估计抓取位置,并让夹爪横跨剪刀。
随后给右臂两个 move:
- 先到剪刀上方;
- 再垂直靠近。
这两条高层 move 被展开成 58 个 action vectors。
第二步:执行后重新看腕相机
下一次 observation 中,右腕相机看到了下面这个画面:
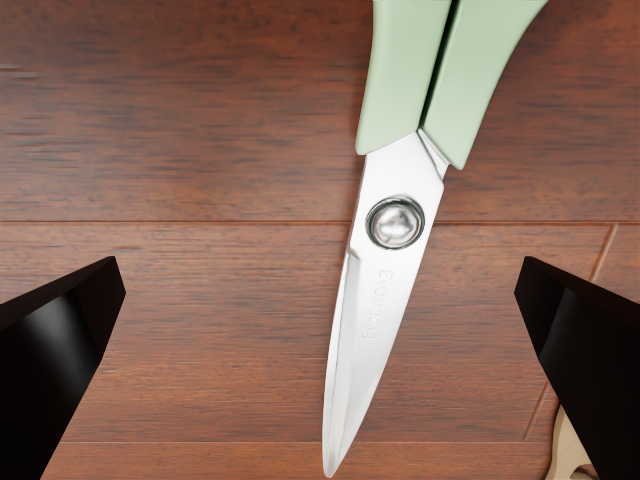
这时腕相机给了模型第二次定位机会。第一段动作执行完后,系统重新读取画面,后面的决策直接依据这个新结果:夹爪有没有对准、物体有没有跟着动,都要重新确认。
此时控制器的下一轮判断大意是:
剪刀刀刃已经位于张开的夹爪之间。闭合右夹爪,然后向上抬 14 cm,再观察剪刀是否跟着移动。
于是形成闭环:
看图
  ↓
定位剪刀
  ↓
生成 waypoint
  ↓
执行几十个动作
  ↓
再看腕相机
  ↓
确认/否定抓取
  ↓
继续或纠错
这就是这个项目里的 “in the loop”。
10. 模型多久看一次?318 次决策 vs 35,646 个动作
318 和 35,646 这两个数字放在一起,基本就能看出上下两层的时间尺度差了多少。
60 次实验一共记录了:
- 318 个模型决策 chunk;
- 35,646 个提交 action vectors;
- 即平均每次高层决策对应大约百级别的低层数值动作。
模型并不会在每个 interpolated action 后重新看图。
真实节奏更像:
Observation #0
     ↓
GPT-6 Astra (xhigh) decision
     ↓
80 action vectors
     ↓
Observation #1
     ↓
GPT-6 Astra (xhigh) decision
     ↓
120 action vectors
     ↓
Observation #2
模型没有在每一个低层 action 后重新推理。这样的节奏更适合承担:
- 物体/指令语义理解;
- 任务分解;
- 中低频几何规划;
- 失败后的策略切换;
- 多步骤状态记忆。
但不适合直接承担:
- 1 kHz 力控;
- 高速碰撞响应;
- 毫秒级 tactile servo;
- 精密插孔过程中的连续顺应控制。
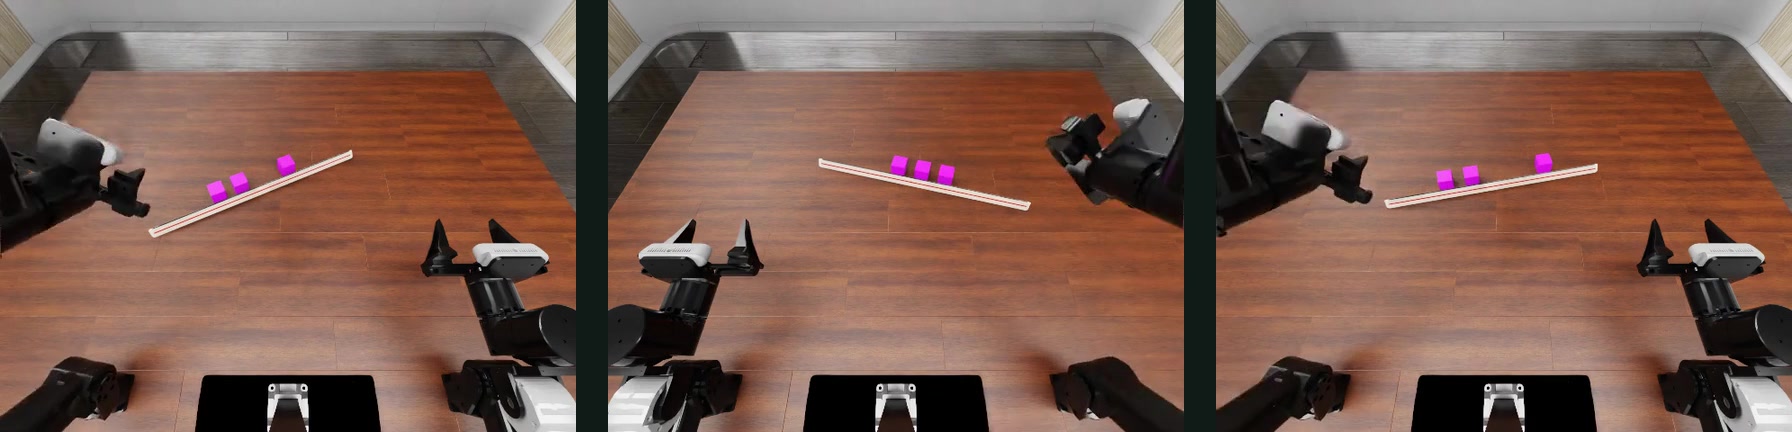
11. 直尺没抓起来,Astra 改成了推
align_blocks 很能说明闭环恢复为什么有用。
初始场景:
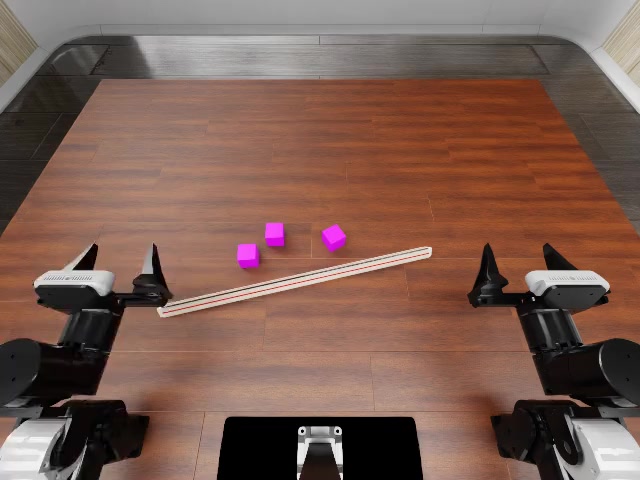
任务最终要求块沿直尺关系对齐。
控制器一开始尝试抓直尺,效果不好。下一轮观察后,它改用了另一种接触方式:
既然直尺本身是一条直边,不一定要把它拿起来;可以用闭合夹爪推动直尺,让直尺作为接触工具,把几个块推到同一直线上。
最终画面:
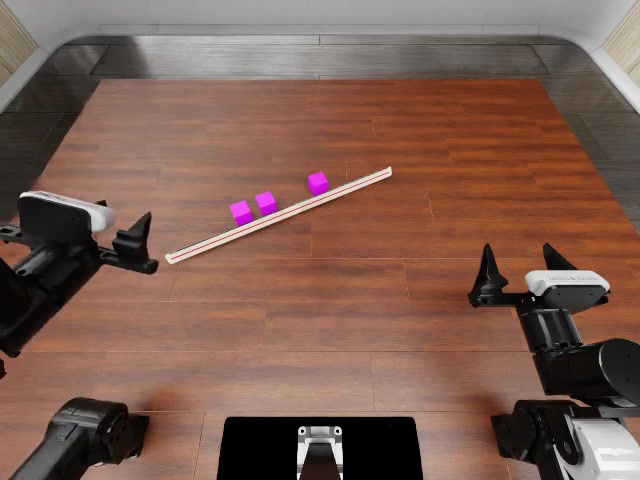
这个任务最终 3/3 全成功,三个 seed 都是原生 100 分。
第一次方案失败后,模型没有继续纠结怎么把直尺抓起来,而是换了一种完成同一目标的方法:
“任务目标不变,但实现手段可以换。”
这和典型的 task-specific policy 有很大区别。固定控制库没有 use_ruler_as_pusher() 这个技能;“把直尺当作推杆/直边”是由上层策略在交互中形成的。
单个案例不足以支持“广泛工具使用能力”这样的结论,不过它提供了一个清楚的例子:上层模型可以在反馈之后改换实现路径,而底层控制接口保持不变。
12. 顺序理解对了,抓取还是可能失败
stack_blocks_by_language 需要模型理解语言条件,并按照指定顺序堆叠颜色块。
初始状态:
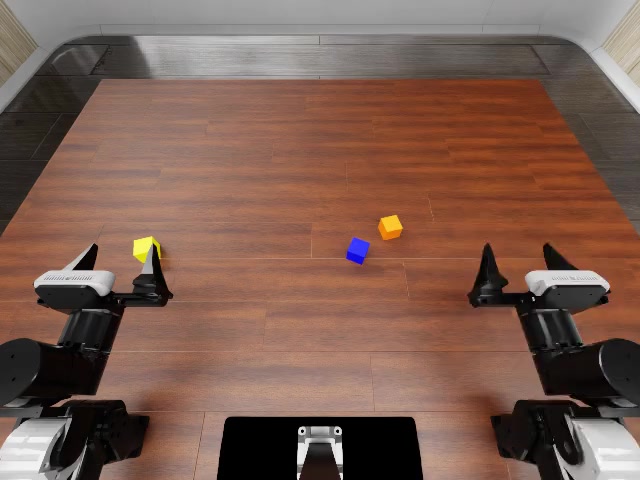
最终有两个 seed 完成:
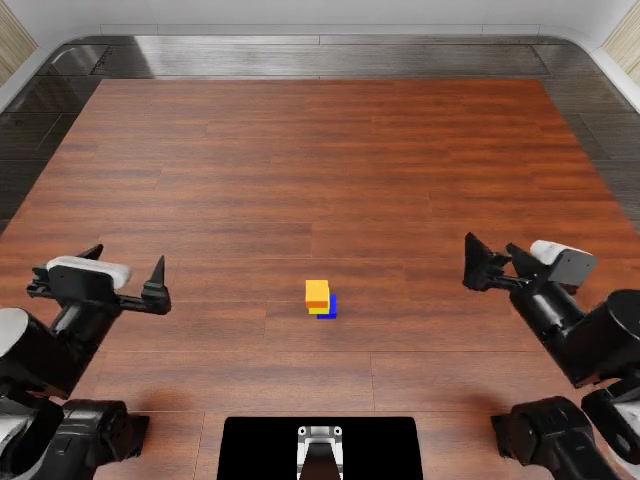
结果是 2/3 成功。
失败的 seed 很有代表性:语言顺序没有弄错,控制器也确实按顺序搬运;真正卡住的是远端橙色块始终抓不稳。把过程拆开,就能看到问题发生在哪一层:
语言理解正确
   ≠
几何定位正确
   ≠
机械臂可达
   ≠
抓取稳定
   ≠
任务最终成功
RoboDojo 最后只给一个 success,但背后串着语言理解、几何定位、可达性和抓取稳定性。调系统时把这些层拆开看,才知道下一步该改模型、感知还是控制器。
13. 方程算对了,机器人还是没拿起来
solve_equation 把“知道答案”和“完成动作”分得很开。
初始场景:
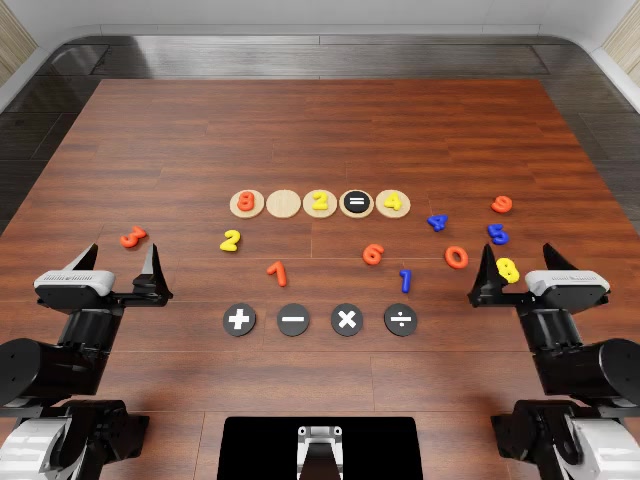
项目保留的 visible rationales 对三道题分别识别出了合理的缺失符号/数字,例如:
8 ? 2 = 4  -> division sign
? / 5 = 0  -> 0
1 + ? = 6  -> 5
但三次最终都是 0 分。
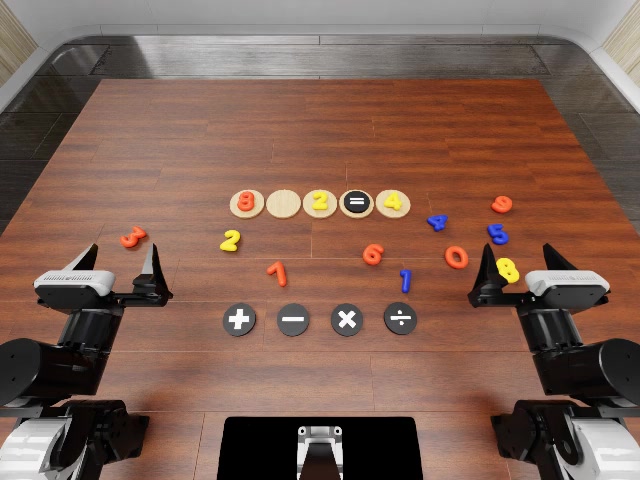
问题出在物理操作:抓取、保持和把目标 token 放到正确位置没有完成。
这个例子把“符号答案正确”和“具身任务完成”分开了。机器人系统里的认知、定位、抓取和放置是串联链路,任一环节失败,最终 success 都可能归零。
14. 为什么精密操作和长序列最难?
五类任务的结果差异很大:
| 维度 | 成功率 | 平均原生得分 |
|---|---|---|
| Open | 50.0% | 50.00 |
| Memory | 25.0% | 31.25 |
| Generalization | 16.7% | 19.58 |
| Precision | 0% | 17.08 |
| Long-Horizon | 0% | 4.17 |
每类只有 4 个任务 × 3 seed,样本量不足以估计整个能力类别的总体水平;这里主要把它当作失败模式的线索。
Precision:单目估计很难支撑毫米级接触
例如:
- 投硬币到窄槽;
- 插钥匙;
- 插管;
- 用槌子敲木琴。
这些任务不仅需要“知道在哪里”,还需要:
- 精确深度;
- 正确接触方向;
- 很小的位置误差;
- 稳定抓持;
- 有时还需要顺应/力反馈。
当前系统只有 RGB + 粗几何估计,因此“看起来靠近了”往往仍不足以完成接触。
Long-Horizon:每一次小误差都会复利
长序列任务常常需要连续搬多个物体。
即使每次单步成功率不算太低,整个任务成功率也会快速下降。比如:
抓第 1 件
 -> 放好
 -> 抓第 2 件
 -> 放好
 -> 抓第 3 件时滑落
 -> 花动作恢复
 -> 前一个物体又被碰偏
 -> native step budget 被耗尽
这也是为什么“能够做一次漂亮抓取 demo”和“能够稳定完成 benchmark long-horizon task”之间差距很大。
15. 18.3% 是整套系统的分数
18.3% 来自一整套 agent + control stack。模型能力只是其中一部分,视觉落点、标定、动作原语、IK、抓持物理和在线恢复都会进入最终结果:
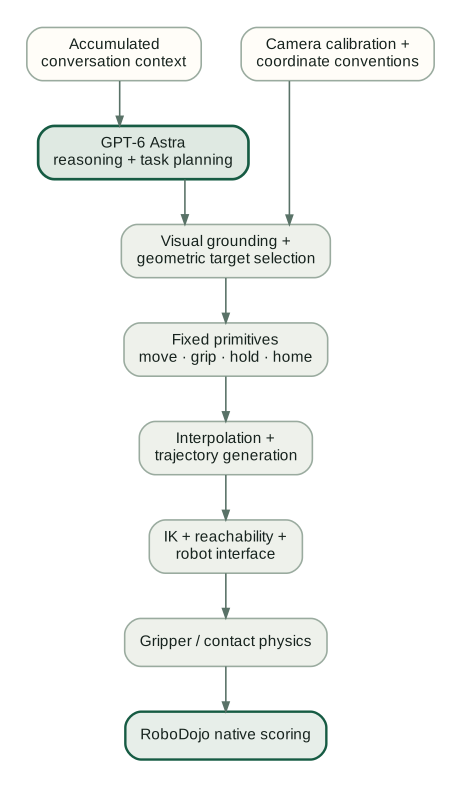
可以近似写成:
System performance =
model reasoning
+ visual grounding
+ camera calibration
+ primitive design
+ trajectory interpolation
+ IK / reachability
+ gripper physics
+ online recovery
+ accumulated conversational context
目前还没有足够的 ablation 把这些因素逐一分离。后续实验如果要回答“提升究竟来自模型还是控制器”,就需要围绕这些层分别做对照。
16. 那 18.3% 到底算高还是低?
RoboDojo 本身是一个很难的 benchmark。项目冻结了 2026-09-05 的公开 leaderboard task-level 数据,并在相同的这 20 个 task names上重新计算了已有模型的均值。
描述性参考如下:
| System | 20-task matched mean score | 20-task matched success rate |
|---|---|---|
| DM0.5 | 28.57 | 25.20% |
| Xiaomi-Robotics-1 | 25.97 | 21.60% |
| GPT-6 Astra (xhigh) + Codex control tools | 24.42 | 18.33% |
| GalaxeaVLA (G0.5) | 20.89 | 16.70% |
| Hy-Embodied-0.5-VLA | 20.24 | 16.15% |
| OpenWAM-α | 16.95 | 13.45% |
这张表只用来给 18.3% 找一个尺度。各系统的 rollout 条件不同,不能据此排出官方名次。
原因包括:
- 本项目每任务只有 3 个 seed、首个公开 layout;
- leaderboard 的布局覆盖和 rollout 数不同;
- 这是 adaptive conversation + numerical tools;
- baseline policy 的执行方式和时间预算不同;
press_by_number有先前开发经验;- 本实验不是官方 submission。
这些数字至少给 18.3% 提供了一个尺度。真正要做严格比较,下一轮应该把 layout、episode 数、step budget 和时间预算对齐,再按同一套协议重跑。
17. 如果换一台完全陌生的机械臂呢?
这里要先区分两种“陌生”。
情况 A:模型没见过这台机器人,但系统提供了机器人的接口说明
例如启动时给一个 machine-readable embodiment contract:
robot: unknown_arm_X
arms:
  right:
    dof: 7
    tool: parallel_gripper
api:
  - observe
  - move_ee
  - move_relative
  - set_gripper
  - hold
  - home
pose_format: [x, y, z, qw, qx, qy, qz]
workspace:
  x: [-0.5, 0.8]
  y: [-0.7, 0.7]
  z: [0.1, 1.4]
cameras:
  - head
- wrist这种情况下,模型不需要在预训练时认识这台机械臂的品牌和关节结构。
只要它知道:
- 我有什么动作能力;
- API 参数是什么意思;
- 机器人坐标系是什么;
- 相机怎样和机器人坐标对应;
- 可达范围和安全限制是什么。
底层 adapter 再把统一的 move_ee() 转成各自机器人的 IK / motion planning。
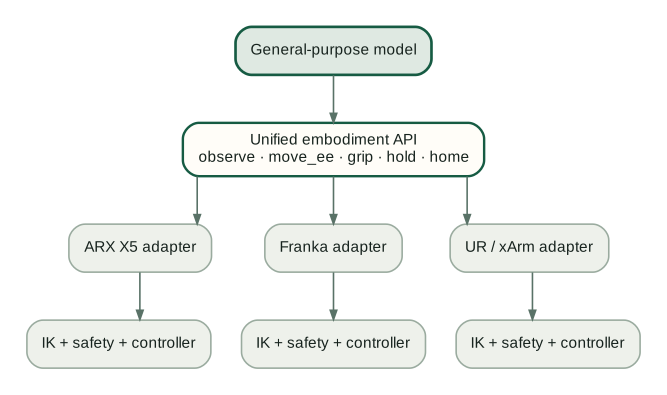
更现实的目标可以写成:
zero-shot over robot identity, not zero-information control.
也就是:机器人可以是第一次见,但控制问题不能没有定义。
情况 B:真的什么都不告诉模型
如果既不给:
- action schema;
- 坐标轴定义;
- 单位;
- joint/EE semantics;
- camera calibration;
- 工作空间;
- 夹爪开合约定;
那这个问题从控制理论上就没有被完整定义。
模型连:
x = 0.3是向前 30 cm、向左 30 cm,还是一个归一化 action 都不知道。
缺少这些定义时,控制问题本身就不完整;模型无法判断同一个数值在这台机器人上对应什么物理含义。
再往前一步,可以研究安全的 active system identification:让 agent 在受限 sandbox 中做小幅试探,结合相机和 proprioception 学习 action semantics。这个方向需要单独设计实验;如果上真机,还要把安全约束放在模型之外的控制层里。
18. 机器人接口固定后,陌生场景怎么处理
如果机器人接口已经定义好,场景即使从没见过,大模型仍然可以依靠视觉语义:
任务:Put the red mug into the blue tray.

RGB:
red mug -> pixel approximately (421, 286)
blue tray -> pixel approximately (177, 331)
然后通过标定/深度估计得到机器人坐标。
理想情况下,可以把当前项目的粗 pixel_to_plane 升级成:
RGB-D / stereo / multi-view
        ↓
3D target estimate
        ↓
visual servo
        ↓
wrist camera refinement
        ↓
grip / contact
尤其值得做的是 coarse-to-fine closed loop:
头部相机:做大范围语义定位
    ↓
机械臂先移动到目标附近
    ↓
腕相机:做近距离几何校正
    ↓
低层视觉/力控制器:完成最后几厘米接触
这种 coarse-to-fine 分层也更贴合两类模块的工作方式:上层处理语义和策略,下层处理连续几何与接触。
19. 精密接触需要另一套时间尺度
假设任务是插钥匙。
在插钥匙这类任务里,上层模型可以负责:
1. 找到钥匙
2. 选择抓取方向
3. 移到锁孔附近
4. 对齐钥匙轴线
5. 开始插入
6. 失败则退回并重试
但最后几毫米可能需要:
- 100–1000 Hz 力反馈;
- tactile sensing;
- compliance;
- impedance control;
- 高频 visual servo;
- 碰撞/安全限制。
合理的分层应该是:
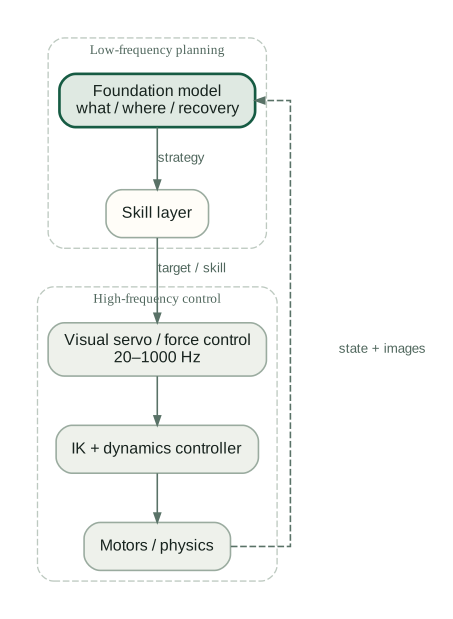
上层模型负责决定做什么、目标在哪里以及失败后怎么调整;低层控制器负责接下来几十毫秒里的视觉伺服、力控和电机动作。两层可以分别升级,实时安全约束也更适合留在下面这一层。
20. 如果继续做,先验证这六件事
如果继续做下一轮,我会优先验证下面六件事。
1)冻结上层策略,再换机器人
保持完全相同:
observe / move_ee / grip / hold / home只把 ARX X5 adapter 换成 Franka、UR5 或其他机器人。
如果不改 prompt、不改 task planner 就还能完成任务,这会直接验证 embodiment abstraction / cross-robot generalization。
2)做 RGB vs RGB-D ablation
当前精密任务最大的瓶颈之一就是深度/接触几何。
比较:
RGB only
vs
RGB + depth
可以很直接地估计“模型推理”和“感知几何误差”各自占多少。
3)加入 wrist visual servo,但保持大模型低频
模型输出目标区域,传统视觉控制器做最后 5–10 cm 的连续校正。
如果 precision task 随之明显改善,就能进一步判断当前瓶颈有多大比例来自近距离几何和接触控制。
4)加入 force/tactile skill
例如提供:
insert_until_contact()
compliant_move(direction, force_limit)
这类 skill 最好保持为通用接触原语,例如按方向顺应移动或接触后停止;若直接提供 task-specific insert_key(),工具层本身就承担了过多任务知识。
5)冻结 context,重复独立 campaign
当前 60 次实验共享一个 adaptive conversation,因此前面任务的经验可能影响后面。
更严格的实验应该比较:
shared context
vs
reset per trial
vs
fixed prompt + frozen controller
6)按统一协议做 matched benchmark evaluation
统一:
- layout coverage;
- episode 数;
- step budget;
- 终止规则;
- 模型版本;
- prompt;
- token/latency 记录;
- 不允许人工中途 steering。
完成这些对齐后,leaderboard context 才能进一步发展成可重复、可排名的 benchmark 结果。
21. 为什么这套分层值得保留
11/60 是这轮实验最醒目的数字。对系统设计更有价值的,是它把通用视觉/语言模型和传统机器人控制栈接成了下面这条链:
通用视觉/语言模型
        ↓
语义理解 + 任务规划 + 几何目标
        ↓
很小的 embodiment API
        ↓
传统机器人 motion stack
        ↓
真实/仿真机器人
这样分层有几个直接好处:
- 动作接口可解释。 可以看到模型到底选择了什么 waypoint、姿态和夹爪状态。
- 机器人低层能力可以复用。 不需要让模型重新学习 IK。
- 容易换 embodiment。 理论上只需要重新实现 robot adapter。
- 失败容易定位。 可以拆成语义错误、几何错误、可达性错误、抓持错误、执行错误。
- 传统安全层可以继续存在。 workspace clamp、collision checking、force limits 不必交给语言模型自己“记住”。
- 模型升级和机器人升级解耦。 上层 foundation model 和下层机器人控制器可以独立迭代。
当前实现的短板也很具体:
- 推理慢;
- 当前视觉几何粗糙;
- 高层动作 chunk 太长时,期间不能即时纠错;
- prompt/context 适应导致评测难标准化;
- 精密接触能力不足;
- 还没有证明真机迁移和跨机器人泛化。
这些问题大多可以分层定位,也为后续版本留下了比较清楚的改进路径。
22. 最后:这次实验说明了什么
这次实验展示的是一种很直接的组合方式:GPT-6 Astra 通过受限的公共观测接口读取 RGB、任务指令和机器人本体状态,在较低频率上负责语义理解、几何目标选择和恢复规划;一个很小的机器人动作 API 再把目标交给轨迹生成、IK 和仿真执行层。
用一句英文写就是:
A general-purpose model does not need to be an end-to-end VLA to control a robot. Given vision, proprioception, and a small embodiment API, it can act as a semantic and geometric planner above conventional robot controllers.
这批结果还不足以证明跨机器人泛化:只有 20 个任务、每个任务 3 个 seed、一台仿真机器人,而且 60 次运行共享上下文。不过它把下一个问题指得很清楚:能不能让 foundation model 使用统一的 embodiment interface,把跨任务的语义和规划留在上层,把运动学、接触控制和安全约束留在机器人控制栈里。
如果这种接口在不同机器人上保持稳定,接入新 embodiment 的主要工作就会转向 adapter、标定和安全层,而不必每次都重新训练一套完整策略。这个问题值得用冻结策略、跨机器人 adapter 和统一评测协议继续验证。
附录:项目中对应的关键文件
如果想沿代码继续深入,可以从这些文件开始:
pilot20/code/model.py:白名单 observation bridge;保存 RGB / instruction / proprioception,等待 action。pilot20/code/control.py:move / grip / hold / home四个数值运动原语,以及位置插值和 quaternion SLERP。pilot20/code/pixel_to_plane.py:从 RGB pixel + 假定平面高度估算三维坐标。pilot20/ops.py:本地 observe / act / launch / collect / archive 调度。pilot20/PROTOCOL.md:60 次实验预注册式协议和信息边界。pilot20/ANALYSIS.md:完整逐任务结果、失败模式、matched leaderboard context。pilot20/remote/pilot20/laneN/<episode>/<request>/:本地研究归档中的原始 RGB、observation.json、action.json和accepted.json;这些大文件没有放进 GitHub Pages 轻量版。paper/manuscript.tex:本地研究工作区中的论文版 Agent and Control Interface 与局限讨论。site/index.html:GitHub Pages 上的轻量结果页,保留 60 次结果、决策摘要和 4 段代表性视频。
数据完整性
项目归档记录:
- 60 份原生结果;
- 180 段原生相机录像;
- 954 张 decision-point RGB;
- 318 个决策 chunk;
- 35,646 个提交 action vectors;
- 2,338 个已审计文件,约 636 MB。
这里还有一个容易误读的数字:提交 action vector 的数量不一定等于真实执行的 physics step 数量;任务可能提前成功、终止或耗尽 step budget。
这篇笔记只讨论这批已保存记录能够支持的结论。它是一轮探索性 RoboDojo 实验,没有做官方 leaderboard submission,也没有验证真机迁移或模型级的通用成功率。
想直接看结果:回到 60 次实验,可以逐个 seed 查看 RoboDojo 得分、成功状态和保存下来的决策记录;4 个代表性任务另外保留了三 seed 并排视频。
这是一轮独立的探索性实验。页面里的 leaderboard 数据用来说明 RoboDojo 的难度和大致尺度,不代表官方名次。